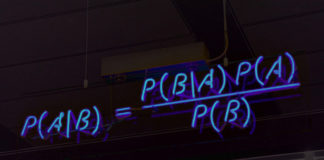Kidnapping, menaces de mort, appels malveillants, fausse alerte à la bombe ou revendication d’attentats terroristes, un nombre croissant de cas délictuels ou criminels impliquent l’étude des documents sonores. Les investigateurs comptent de plus en plus sur les experts pour en l’identification vocale d’un auteur. Mais la voix est-elle unique ? Peut-on identifier formellement un locuteur ?
Les réponses à ces questions sont complexes. D’une part, à l’inverse d’une empreinte digitale ou d’un profil génétique qui présentent des caractéristiques fixes, la voix d’une personne varie en fonction de nombreux facteurs “internes”. Par exemple, la voix change avec la fatigue, la maladie, la rapidité et la force du discours ou encore par la volonté de l’auteur de déguiser sa voix. D’autre part, la voix peut être plus ou moins perturbée par des facteurs externes, comme les bruits de fond, le type ou la qualité d’un enregistrement. Un expert doit comparer des enregistrements réalisés sur des téléphones, des cassettes, des CD, des DVD ou encore sur des supports numériques. Ces enregistrements ont une influence sur la retranscription de la voix, et la difficulté de l’expertise n’en est que plus grande.
Qu’est-ce qu’une voix ?
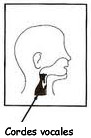
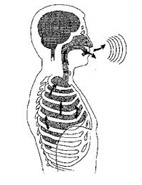
La voix est définie par le dictionnaire Larousse comme “l’ensemble des sons produits par les vibrations périodiques des cordes vocales”. Nos cordes vocales sont notre principal instrument, mais pour émettre et moduler un son, nous utilisons de nombreux organes. D’abord, pour créer un son, nous faisons travailler nos abdominaux : le niveau sonore varie en fonction de la quantité d’air expiré des poumons et selon la pression que nous mettons. Ensuite, le voile du palais, la langue et les lèvres nous permettent d’articuler les sons. Enfin, le nez, la bouche et le pharynx servent de caisse de résonance, ils sont utilisés pour moduler le son. Les sons produits sont de nature vibratoire et sont caractérisés par leur fréquence (aiguë, grave, médium).
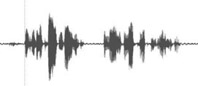
Les vibrations produites sont transmises dans le milieu ambiant et se propagent dans l’air par des variations de pression. Ces sons sont ensuite reçus par un récepteur comme un microphone ou nos oreilles. Nos oreilles sont sensibles aux vibrations de fréquences comprises entre 16 Hz et 20 000 Hz (Hz = HERTZ, unité de mesure de la fréquence, sachant que 1 Hz = 1 oscillation par seconde). Notre système auditif se charge ensuite de transformer ces vibrations de l’air en une information décodable par le cerveau en tant que son.
Un enregistrement vocal contiendra deux types d’informations principales à analyser : des informations auditives relatives au contenu et à la phonétique du message et des informations acoustiques propres au signal vocal.
Une voix est-elle unique ?
Des observations informelles suggèrent qu’une voix pourrait être unique à un individu, comme son ADN même si cela n’a pas été prouvé scientifiquement. L’unicité de la voix, comme l’unicité d’une empreinte papillaire, est pourtant un postulat admis de tous. Pour l’empreinte digitale, ce postulat peut facilement être illustré par des probabilités et des études empiriques, car le dessin papillaire ne varie pas, quelque soit l’état des personnes ou du support. En effet, une des trois caractéristiques principales d’une empreinte papillaire est son invariabilité. En revanche, cette unicité n’est pas simple à démontrer pour la voix qui n’a pas des caractéristiques fixes. La voix est sujette à une immense gamme de variations.
La voix d’un individu est toutefois considérée comme unique. L’identification vocale n’en reste pas moins difficile et dépendante de la qualité des enregistrements.
[eap_ad_1]
Les variations des voix, intra et inter-variabilité
Une des difficultés de l’identification vocale réside dans les variabilités qui existent à la fois dans la voix d’un même locuteur, mais aussi dans les voix des différents individus.
Les variations propres à chaque individu :
Ces sources de variations dépendent uniquement de facteurs propres aux capacités de l’orateur, on parle “d’intra-variabilité”.
Il manque encore des données sur cette intra-variabilité, car très peu d’études à grande échelle ont été réalisées. Ces types d’études sont indispensables pour interpréter les résultats. Par exemple, lors d’une comparaison vocale, si l’expert se trouve confronté à des différences entre deux échantillons de voix, il doit pouvoir dire si ces différences sont dues à une modification de la voix d’un même locuteur ou alors s’il s’agit de deux locuteurs différents. Des études statistiques sur une grande population doivent permettre :
– d’évaluer la probabilité des “intra-variations” en fonction de facteurs agissant souvent dans des cas criminels (stress, voix déguisée, émotions)
– d’évaluer de manière adéquate l’étendue des variables phonétiques qui pourraient contribuer à l’identification d’un individu parmi une population d’orateurs.
Les variations entre différents individus :
Ces sources de variations dépendent de facteurs propres à chaque individu, on parle alors “d’inter-variabilité”.
Il est indispensable d’avoir accès à une base de données composée par de nombreux locuteurs. Cela permet d’évaluer la fréquence de certaines caractéristiques vocales dans une population et de déterminer la probabilité que quelqu’un choisi au hasard, ait pu être à l’origine de l’élément vocal suspect.
Pour répondre à ces besoins, entre 2005 et 2009, l’université de Cambridge a réalisé une base de donnée comprenant les voix de 100 orateurs, enregistrés sous diverses conditions, au cours du programme nommé Dynamic Variability in Speech.
Les techniques de comparaison vocale
Les deux méthodes principales pour comparer des échantillons de voix sont les méthodes semi-automatiques et les méthodes automatiques. Les deux méthodes peuvent être utilisées l’une en complément de l’autre.
Les méthodes de reconnaissance automatique de l’orateur sont de plus en plus utilisées pour l’identification vocale en criminalistique, car elles sont maintenant de plus en plus précises dans des conditions d’enregistrement contrôlées. Avec ce type de technique, les modèles statistiques des paramètres acoustiques des voix de locuteurs et des paramètres acoustiques de documents suspects, sont comparés. Des caractéristiques sont extraites d’une pièce de question (trace audio) et d’une pièce de comparaison (enregistrement du suspect). La force de la preuve est ensuite calculée par la probabilité d’observer les caractéristiques de la pièce de question par rapport au modèle statistique de référence de la voix d’un suspect et par rapport à des modèles statistiques des voix d’une population. En clair, il s’agit de déterminer s’il est plus probable que la voix incriminée appartienne à un suspect ou que la voix incriminée appartienne à un individu pris au hasard dans une base de donnée. Cette évaluation est en fait l’application du théorème de Bayes.
En revanche, ces méthodes automatiques doivent être adaptées à des conditions d’enregistrement qui ne sont pas contrôlées et qui sont parfois de mauvaise qualité. En effet, des différences dans le “canal de transmission” de la voix (internet, téléphone) et dans l’appareil d’enregistrement peuvent introduire des variations importantes. Il est alors nécessaire de savoir évaluer l’influence de ces conditions d’enregistrement lors de la reconnaissance automatique des locuteurs. Cette évaluation reste un des problèmes majeurs de l’identification vocale par un système automatique.
L’identification vocale, évaluation de la preuve
Depuis toujours, nous reconnaissons et identifions des voix familières et nous sommes mêmes capables de distinguer entre plusieurs voix entendues deux ou trois fois. Il est admis que chaque voix est unique mais la variabilité importante (intra et inter-variabilité) fait qu’il n’y a pas connaissance d’un jeu de critères qui permette d’affirmer à 100% qu’un individu est l’auteur d’un message audio. En revanche, à l’aide de bases de données, il est possible de dire si un individu suspect a plus de chance d’être à l’origine d’un document audio incriminé que quelqu’un d’autre pris au hasard dans la population. Pour cela, il est nécessaire d’utiliser une structure de circonstance. Comme pour d’autres domaines de la criminalistique, la bonne structure pour interpréter et évaluer la force de la preuve en mettant deux hypothèses opposées en compétition, reste l’utilisation du théorème de Bayes.
Les deux hypothèses mises en compétition sont les suivantes :
H1: le suspect est à l’origine de l’enregistrement audio incriminé
H2: le suspect n’est pas à l’origine de l’enregistrement audio incriminé
Les deux probabilités à calculer sont les suivantes :
P (E/H1) : probabilité d’observer l’enregistrement audio incriminé sachant que le suspect en est à l’origine
P (E/H2) : probabilité d’observer l’enregistrement audio incriminé sachant que le suspect n’en est pas à l’origine
Pour évaluer la force de la preuve, il est nécessaire d’évaluer le rapport entre la probabilité d’observer l’enregistrement audio incriminé si celui-ci provient du suspect, et la probabilité d’observer l’enregistrement audio de question si celui-ci provient d’une autre personne que le suspect (rapport de vraisemblance = Likelihood Ratio = LR).
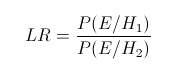
Pour évaluer correctement ces deux probabilités, il est indispensable de se référer à des bases de données.
Une première base de donnée, comprenant de nombreux locuteurs, permet de déterminer la probabilité que quelqu’un choisi au hasard ait pu laisser la trace. Ce type de base de donnée est utile pour évaluer la fréquence de certaines caractéristiques vocales dans une population (inter-variabilité).
Une deuxième base de données, comprenant des enregistrements du suspect dans les même conditions standard que dans la première base de donnée, permet d’évaluer la probabilité d’observer l’enregistrement audio incriminé si le suspect n’est pas à l’origine de la trace P(E/H2)
Une troisième base de de données, réalisée dans des conditions d’enregistrement proches de celles de l’enregistrement audio incriminé, permet de déterminer la probabilité d’observer l’enregistrement audio incriminé si le suspect est à l’origine de la trace P(E/H1)
A l’aide de la méthode automatique et du théorème de Bayes, les progrès récents permettent de confondre un suspect avec de fortes probabilités. Pour cela, les bases de données qui sont parfois enregistrées dans des conditions acoustiques et techniques différentes, sont indispensables pour renforcer l’importance de la preuve. Pour évaluer la preuve de façon pertinente, les influences des conditions de transmission, d’enregistrement et d’encodage doivent être connues et comprises avec précision.
En plus de l’identification vocale du locuteur, l’étude d’un document vocal est riche en informations. Elle peut permettre d’en savoir plus sur les caractéristiques individuelles de l’orateur et sur son niveau social et culturel. L’analyse peut aussi être couplée avec l’authentification du document sonore, l’amélioration du son par ordinateur, la retranscription exacte du discours ou l’analyse des bruits de fond. Avec toutes ces possibilités et les nombreuses avancées technologiques, l’identification vocale reste un domaine complexe mais promis à un brillant avenir.